Vision AI on Edge Device
산업 현장의 카메라에서 시작해 다양한 경량 Vision 모델, 모델 최적화, NPU, Runtime, MLOps로 이어지는 Edge Vision AI 생태계를 살펴봅니다.
오랜만입니다. 그간 바쁘기도 했고, 회사 내에서 개인의 업무와 내 커리어의 방향성에 대해서 동시에 고민해나가는 과정에서 어떤 글을 쓸지 갈피를 잡지 못했습니다.
그간 회사에서 프론트엔드를 넘어 백엔드와 실시간 영상 스트리밍을 다루게 되었고, 최근에는 Vision AI와 이를 위한 MLOps 플랫폼을 개발하고 있습니다. 자연스럽게 AI 모델 자체뿐만 아니라 모델이 실제로 어떤 환경에서 구동되고 서비스되는지에 대해서도 고민할 일이 많아졌습니다.
그 과정에서 본격적으로 접하게 된 것이 Edge AI입니다. 처음에는 단순히 AI 모델을 작은 컴퓨터에서 돌리는 정도로 생각했는데, 직접 산업용 Edge Device를 다루고 모델을 배포해보니 생각보다 꽤 큰 생태계가 만들어져 있었습니다. 다양한 경량 Vision 모델부터 GPU와 NPU, 모델 최적화, 추론 Runtime, 실시간 영상 처리, 그리고 여러 Edge Device와 모델을 관리하기 위한 MLOps까지 서로 긴밀하게 연결되어 있었습니다.
오늘은 제가 업무를 통해 접하게 된 Edge Vision AI와 그 안에서 사용되는 기술들에 대한 이야기를 해보려고 합니다.
왜 Edge AI인가
우리가 흔히 사용하는 GPT나 Claude 같은 AI 서비스는 대부분 클라우드에서 동작합니다. 강력한 컴퓨팅 자원을 중앙에 모아두고, 사용자가 데이터를 보내면 서버에서 처리한 결과를 다시 전달하는 방식입니다.
하지만 Vision AI처럼 지속적으로 영상 데이터를 처리해야 하는 경우에는 이야기가 조금 달라집니다. 수십 대의 CCTV 영상을 계속 클라우드로 전송하면 네트워크 사용량과 서버 비용이 커지고, 네트워크 상태에 따라 지연이나 장애가 발생할 수도 있습니다. 영상에는 사람이나 내부 시설처럼 외부로 전송하기 민감한 정보가 포함될 수도 있습니다.
그래서 나온 방식이 데이터가 발생하는 곳에서 바로 AI를 구동하는 Edge AI입니다.
Edge AI
Edge AI는 AI 모델을 현장에 위치한 Edge Device에 직접 배포하고 그 장치에서 모델을 구동하는 방식입니다. Vision AI에서는 보통 CCTV나 카메라와 가까운 곳에 Edge Device를 두고 영상을 직접 분석합니다.
예를 들어 공장 CCTV에서 작업자의 안전모 착용 여부를 판단한다고 하면 모든 영상을 서버로 보내는 대신 Edge Device에서 영상을 분석하고, 서버에는 “안전모 미착용 작업자가 감지되었다”와 같은 결과만 전달할 수 있습니다.
카메라는 엄청난 양의 데이터를 만들어내지만 우리가 실제로 필요한 것은 영상 자체가 아니라 영상에서 추출한 정보인 경우가 많습니다. 이런 특성 때문에 Vision AI는 Edge AI와 특히 궁합이 좋은 분야입니다.
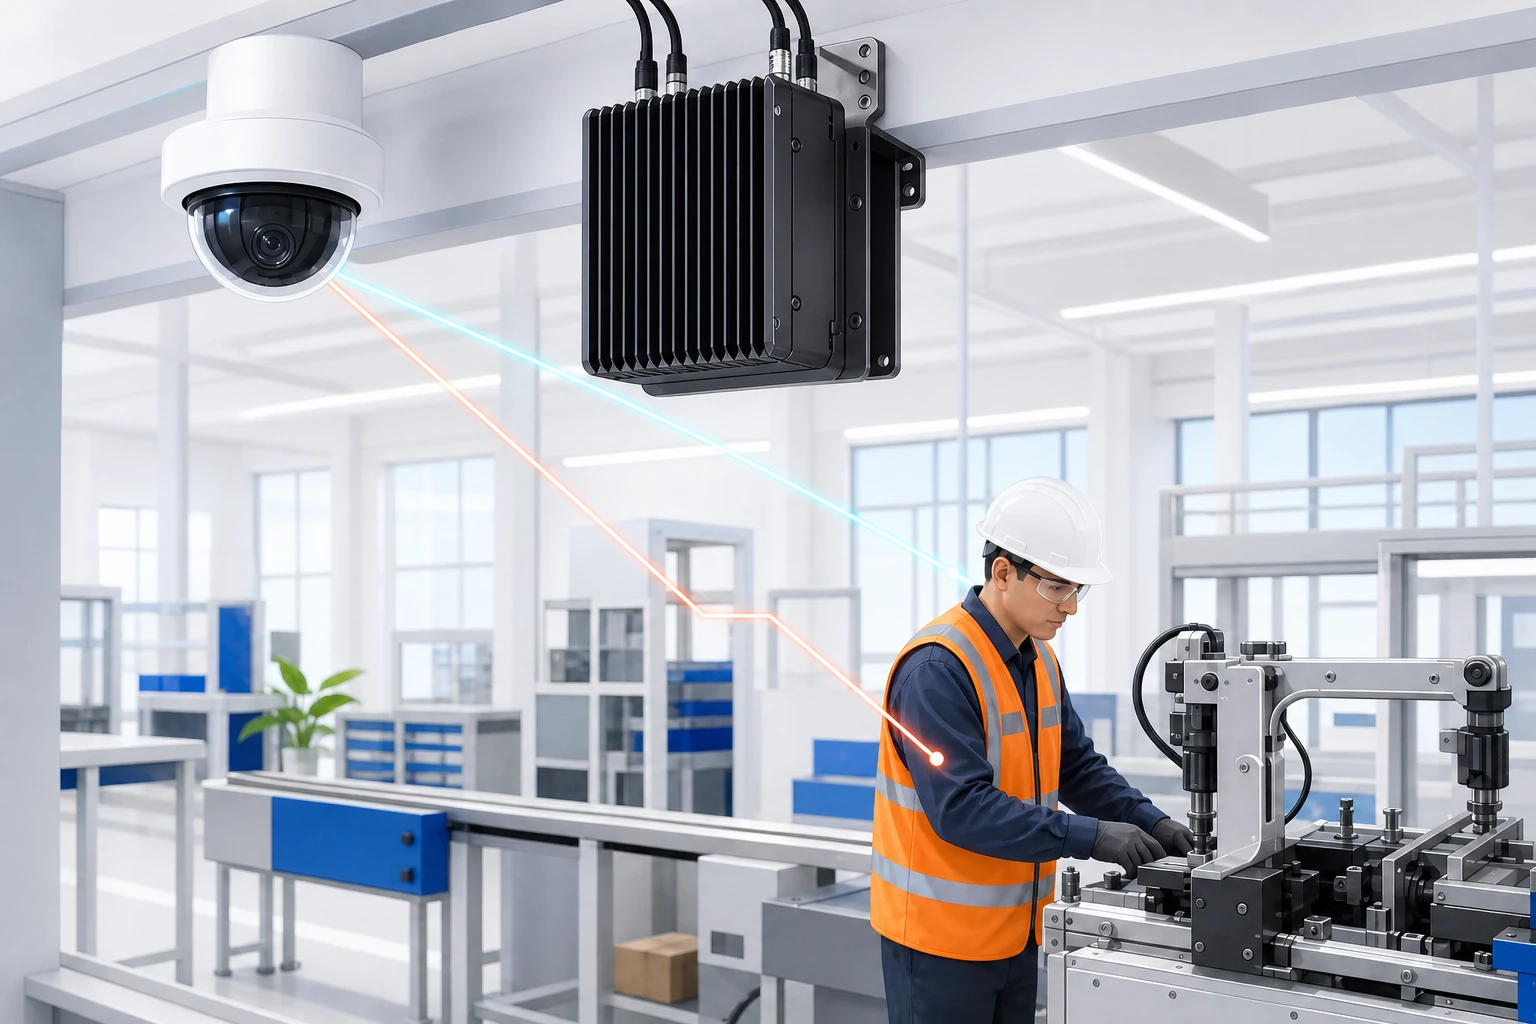
CCTV 영상을 현장 가까이에서 처리하는 Edge AI 구성 개념도. 이 글을 위해 제작한 이미지입니다.
Edge Vision AI는 무엇을 하나요?
Vision AI라고 해서 모두 같은 일을 하는 것은 아닙니다. 이미지나 영상을 어떤 방식으로 분석하느냐에 따라 여러 종류의 Task가 존재합니다.
가장 기본적인 것은 Classification입니다. 이미지 전체가 어떤 종류인지 판단하는 방식으로, 사진을 보고 고양이인지 강아지인지 분류하는 것이 대표적인 예입니다. 반면 Object Detection은 이미지 안에 어떤 물체가 존재하는지뿐만 아니라 그 물체가 어디에 있는지까지 찾아냅니다. CCTV 영상 속 사람, 차량, 안전모, 화재 등을 사각형 영역인 Bounding Box로 표시하는 방식입니다.
조금 더 정밀한 영역이 필요한 경우에는 Segmentation을 사용할 수도 있습니다. Bounding Box가 물체 주변을 사각형으로 감싼다면 Segmentation은 실제 물체가 차지하는 영역을 픽셀 단위로 구분합니다.
실제 산업 현장에서는 목적에 따라 이러한 기술들이 사용됩니다. 공장에서는 제품의 불량을 검사하거나 작업자의 안전장비 착용 여부를 확인할 수 있고, 물류센터에서는 사람과 차량의 이동을 감지할 수 있습니다. 화재나 연기, 침입자, 위험구역 진입처럼 CCTV를 이용한 실시간 이벤트 감지 역시 대표적인 활용 사례입니다.
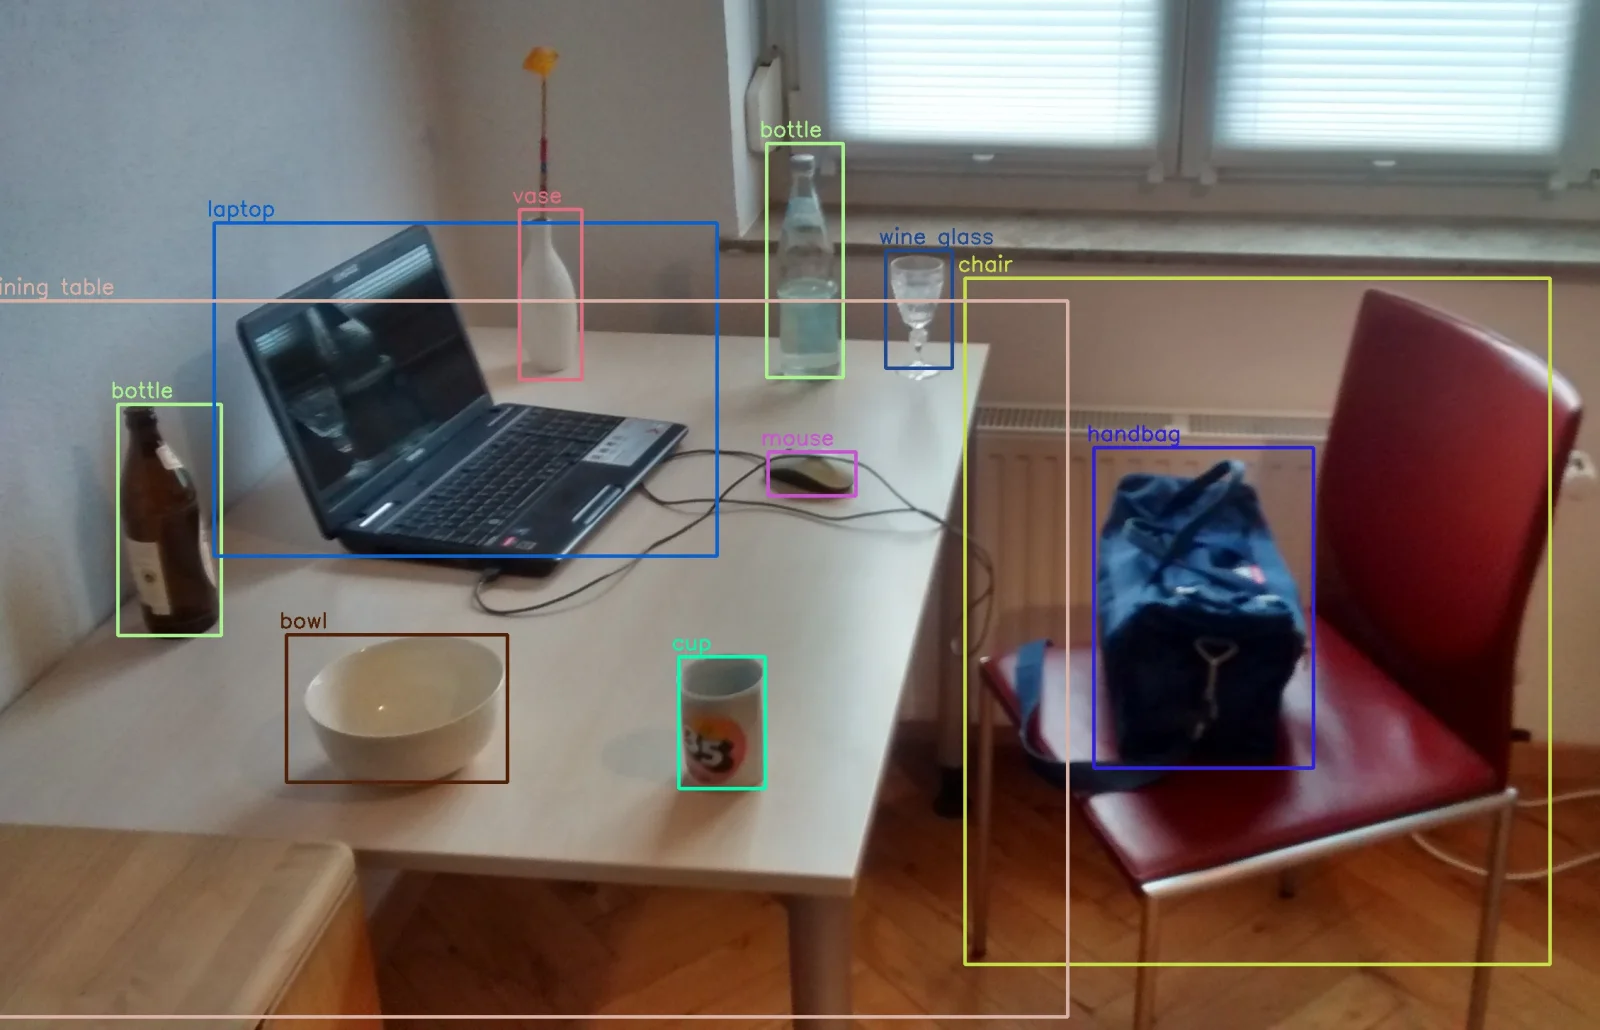
이미지: MTheiler, CC BY-SA 4.0. 크기 조정 및 WebP 변환.

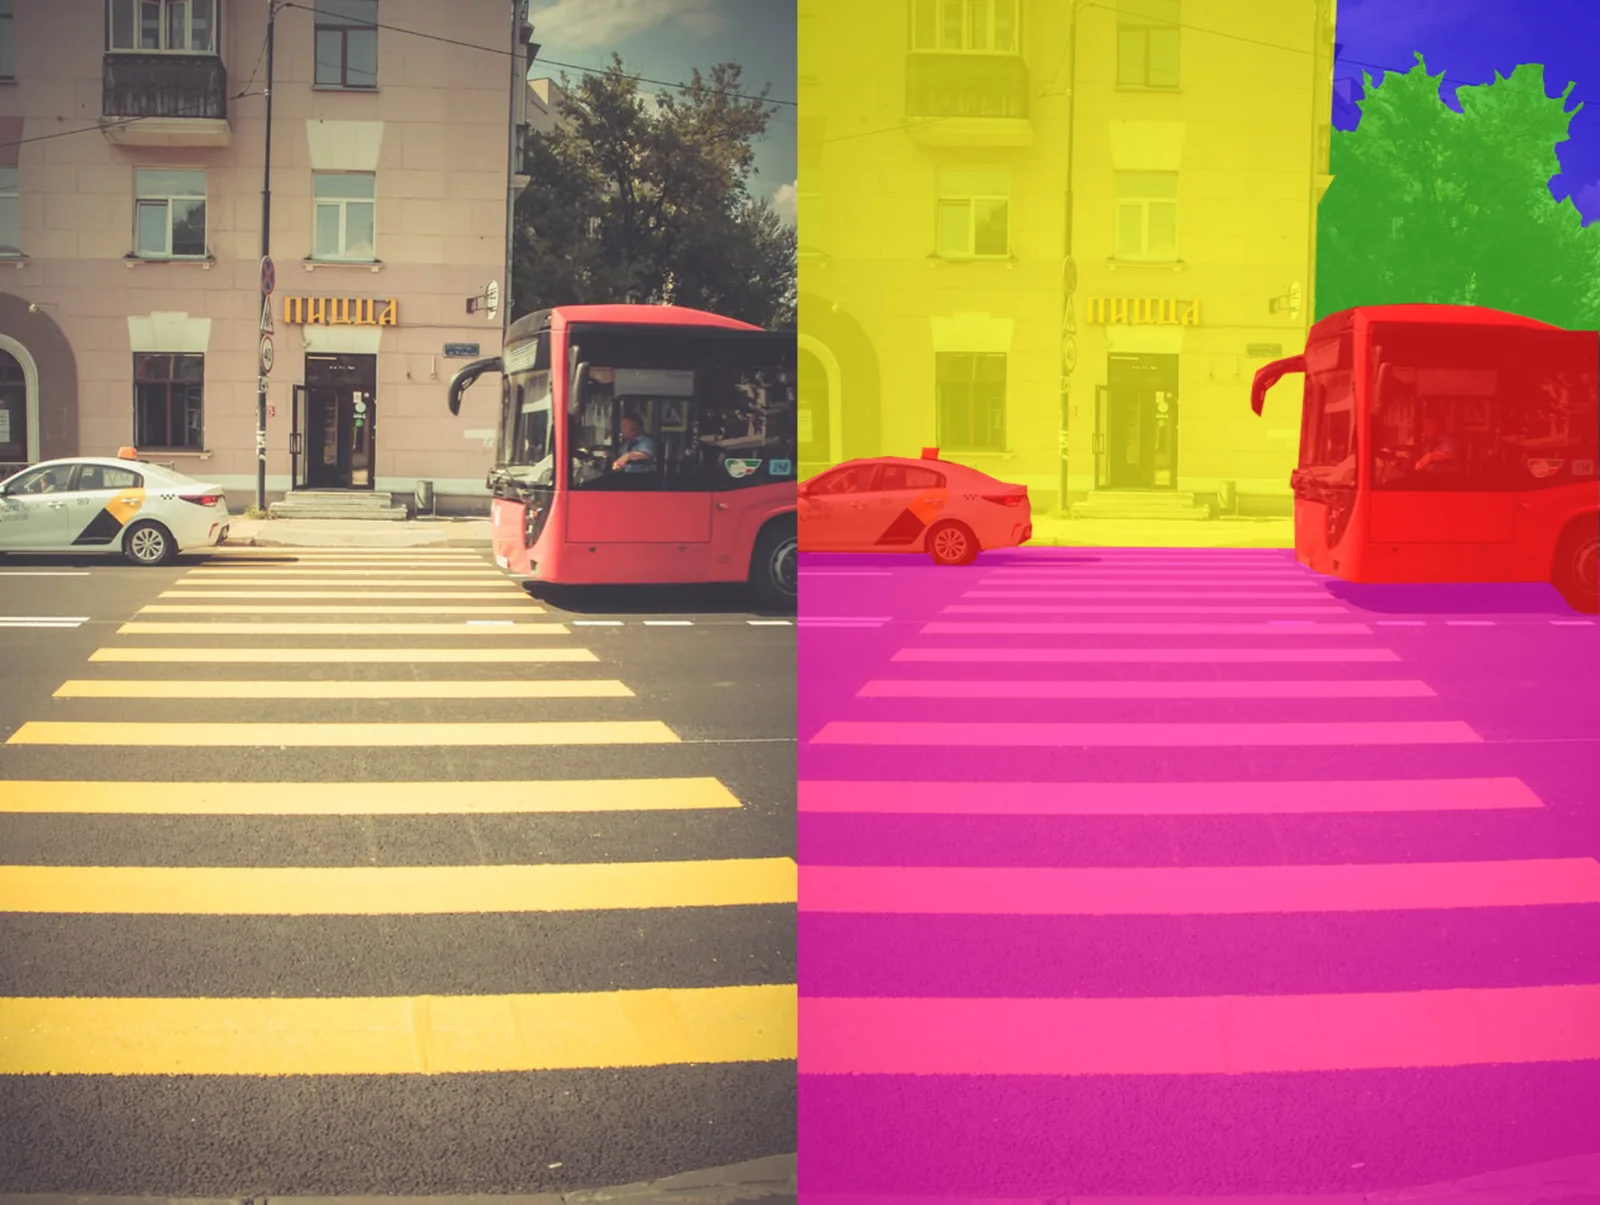
이미지: B.Palac, CC BY-SA 4.0. 크기 조정 및 WebP 변환.

Edge에서 구동되는 Vision 모델의 종류
Edge에서 구동하는 것을 목적으로 하는 Vision 모델은 다양합니다. 수행하려는 Task에 따라 모델이 달라지기도 하고, 여러 모델을 함께 구동해 특수한 목적에 맞게 응용하는 경우도 있습니다.
이미지 전체의 종류만 구분하면 되는 Classification에서는 MobileNet이나 EfficientNet처럼 모바일과 임베디드 환경을 염두에 둔 가벼운 모델을 사용할 수 있습니다. 이런 모델은 그 자체로 분류에 사용되기도 하고, Detection이나 Segmentation 모델에서 이미지의 특징을 추출하는 Backbone으로 활용되기도 합니다. 제한된 CPU나 모바일 NPU에서도 실행할 수 있을 만큼 작은 모델이 필요하다면 여전히 유용한 선택지입니다.
Ultralytics YOLO
Real-time object detection
로고마크: Ultralytics 공식 Assets 저장소.
Object Detection에서도 선택지는 넓습니다. YOLO 계열은 전통적으로 CNN을 중심으로 특징을 추출하고 위치와 Class를 예측하는 One-stage Detector입니다. 속도와 정확도, 학습 및 배포 도구의 균형이 좋고 다양한 Runtime에서 최적화하기 쉬워 현장에서 널리 사용됩니다.
반면 DETR 계열은 Transformer와 Object Query를 이용해 Detection을 End-to-End의 Set Prediction 문제로 다룬다는 점에서 YOLO 계열과 구조적인 차이가 있습니다. 원래의 DETR은 학습 수렴이 느렸지만, Baidu의 RT-DETR은 실시간 추론을 목표로 이를 개선했고 Roboflow의 RF-DETR은 사전학습된 DINOv2 Backbone을 활용해 새로운 Domain에 효율적으로 적응하는 방향을 택했습니다. 다만 DETR 계열이라고 해서 항상 더 빠르거나 정확한 것은 아닙니다.
모델별 비교
먼저 모델마다 주로 해결하는 문제와 배포 환경이 다릅니다.
표는 좌우로 스크롤할 수 있습니다.
모델 계열 | 주 기능 | 구조와 특징 | 공식 성능·규모 | 적합한 환경 |
|---|---|---|---|---|
MobileNetV3 | Classification, Backbone | 초경량 CNN, 낮은 연산량 | Top-1 67.7–75.3% · 2.5–5.5M | 모바일 CPU·NPU, 저전력 Device |
EfficientNet-B0 | Classification, Backbone | 정확도와 모델 크기의 균형 | Top-1 77.7% · 5.3M | 모바일·Embedded NPU |
YOLO26 | Detection, Segmentation, Pose, OBB | CNN 중심, End-to-End 추론과 넓은 Runtime 지원 | COCO AP 40.9–57.5 · 2.4–55.7M | CPU·NPU부터 Edge GPU까지 |
RT-DETR | Object Detection | End-to-End DETR, Decoder 조절 가능 | COCO AP 53.0–54.8 · 32–67M | GPU·AI Accelerator 기반 Edge Server |
RF-DETR | Detection, Segmentation, Keypoint | DINOv2 Backbone, Domain 적응 지향 | COCO AP 48.4–60.1 · 30.5–126.9M | GPU 기반 Edge·Edge Server |
Classification의 ImageNet Top-1과 Object Detection의 COCO AP는 서로 다른 지표이므로 계열 사이의 숫자를 직접 비교할 수는 없습니다.
Object Detection 모델은 같은 계열 안에서도 크기에 따라 정확도와 요구 자원이 크게 달라집니다. 아래 수치는 각 프로젝트가 공개한 COCO AP50–95, Parameter 수와 NVIDIA T4 TensorRT 기준 추론 속도입니다.
표는 좌우로 스크롤할 수 있습니다.
모델 | COCO AP | Params | T4 속도 | 권장 추론 환경 |
|---|---|---|---|---|
| YOLO26n | 40.9 | 2.4M | 1.7ms | 모바일 NPU·저전력 Edge |
| YOLO26s | 48.6 | 9.5M | 2.5ms | NPU·Entry Edge GPU |
| YOLO26m | 53.1 | 20.4M | 4.7ms | Embedded GPU·고성능 NPU |
| YOLO26l | 55.0 | 24.8M | 6.2ms | 중급 Edge GPU |
| YOLO26x | 57.5 | 55.7M | 11.8ms | 고성능 Edge GPU·Edge Server |
| RT-DETR-L | 53.0 | 32M | 114 FPS | GPU·AI Accelerator Edge Server |
| RT-DETR-X | 54.8 | 67M | 74 FPS | 고성능 GPU Edge Server |
| RF-DETR-N | 48.4 | 30.5M | 2.3ms | GPU·NPU 기반 Edge |
| RF-DETR-S | 53.0 | 32.1M | 3.5ms | Embedded GPU·Edge Server |
| RF-DETR-M | 54.7 | 33.7M | 4.4ms | 중급 GPU Edge Server |
| RF-DETR-L | 56.5 | 33.9M | 6.8ms | 고성능 GPU Edge Server |
| RF-DETR-XL | 58.6 | 126.4M | 11.5ms | Server급 GPU |
| RF-DETR-2XL | 60.1 | 126.9M | 17.2ms | 정확도 우선 Server급 GPU |
속도는 각 프로젝트의 공식 측정값으로, YOLO26과 RF-DETR은 ms, RT-DETR은 FPS로 공개되었습니다. Framework와 TensorRT 버전 등 측정 절차가 달라 계열 간 절대 순위로 비교할 수는 없습니다. 권장 환경은 Parameter 수와 공식 Benchmark를 바탕으로 한 상대적인 추론 등급이며, 입력 해상도·Precision·Stream 수·Runtime에 따라 달라집니다.
현업에서의 모델 선택
표를 보면 한 가지 특징이 있습니다. 표에 포함된 실시간 Object Detection 모델 가운데 Parameter가 10M 안팎까지 줄어드는 계열은 YOLO가 유일합니다. YOLO26n이 2.4M, YOLO26s가 9.5M인 데 비해 가장 작은 RF-DETR-N도 30.5M입니다. Roboflow도 RF-DETR-N의 Edge 실행 사례로 NVIDIA Jetson Orin Nano에서 약 25 FPS를 제시합니다. 여러 대의 Camera Stream을 Decode하면서 추론까지 처리해야 하는 환경이라면 RF-DETR의 시작점부터 가볍다고 보기는 어렵습니다.
단순히 모델이 요구하는 Hardware 사양만의 문제도 아닙니다. Edge Device로는 NVIDIA Jetson뿐 아니라 Hailo 같은 NPU 가속기, 휴대폰, Linux 기반 Mini PC도 쓰입니다. Device가 모델의 Operator를 지원하는지, OS에서 사용할 Runtime과 Compiler가 준비되어 있는지까지 확인해야 합니다.
Ultralytics YOLO는 ONNX와 TensorRT뿐 아니라 CoreML, LiteRT, ExecuTorch, Qualcomm QNN, Hailo까지 공식 Export 경로를 제공합니다. RF-DETR도 QNN과 CoreML, TFLite 등으로 지원 범위를 넓히고 있지만 아직 Hailo를 직접 겨냥한 Export는 제공하지 않습니다. 특정 NPU에서 실행하려면 ONNX 변환 이후에도 지원 Operator와 Quantization 과정을 모델별로 다시 검증해야 합니다. 적어도 제가 접한 환경에서 대부분 YOLO를 채택한 이유는 Benchmark보다 이 차이에 가까웠습니다.
문제는 Ultralytics가 공개한 YOLO 코드와 모델이 AGPL-3.0이라는 점입니다. 비공개 상용 제품에 적용하려면 라이선스 의무를 검토하거나 Enterprise License를 구입해야 합니다. Apache 2.0으로 제공되는 RT-DETR과 RF-DETR의 Core 모델이 대안이 될 수 있지만, 앞서 살펴본 모델 크기와 배포 환경의 제약을 다시 감수해야 합니다. 기술적으로는 YOLO가 가장 수월한데 상용화 단계에서는 라이선스가 걸리는 것이 현재 Edge Vision AI의 현실에 가깝습니다.
모델 경량화
모델을 가볍게 만드는 가장 단순한 방법은 처음부터 작은 모델을 선택하는 것입니다. Classification이라면 MobileNet이나 EfficientNet의 작은 Variant를, Object Detection이라면 YOLO의 Nano나 Small 모델을 선택하는 방식이 대표적입니다. 하지만 이미 만들어진 모델 자체를 더 효율적으로 실행하기 위한 다양한 최적화 기술도 존재합니다.
대표적인 것이 Quantization(양자화)입니다. 숫자의 정밀도를 낮추는 대신 필요한 메모리와 연산량을 줄여 모델을 더 빠르고 효율적으로 실행합니다.
이외에도 중요도가 낮은 Weight나 연산을 제거하는 Pruning, 큰 모델이 학습한 정보를 작은 모델에 전달하는 Knowledge Distillation 같은 방법이 있습니다. 입력 이미지의 Resolution을 낮추는 것 역시 실무에서는 매우 직접적인 최적화 방법입니다.
결국 모델 경량화는 단순히 모델 파일의 크기를 줄이는 작업이 아닙니다. 모델이 요구하는 계산량과 메모리를 줄여 제한된 하드웨어에서도 현실적인 성능을 얻는 과정에 가깝습니다.
Edge Device 고르기
모델을 충분히 가볍게 만들었다면 다음으로 중요한 것은 어떤 하드웨어에서 이 연산을 처리할 것인가입니다. Edge Device는 NPU가 달린 작은 Board 하나를 뜻하지 않습니다. 모델의 크기와 Camera 수, 필요한 FPS뿐 아니라 설치 환경, 전원, 발열, 입출력, 공급 기간까지 포함해서 선택해야 하는 하나의 System입니다.
직접 선택하고 구축할 수 있는 Edge Device
Raspberry Pi 같은 Single Board Computer는 초경량 모델을 시험하거나 낮은 빈도의 단일 Stream을 처리하는 데 여전히 유용합니다. 다만 실제 산업 현장에서는 Board에 가속기를 붙이는 것보다, 가속기와 전원·냉각·통신 포트를 하나의 Chassis에 통합한 산업용 Edge AI Box를 선택하는 경우가 많습니다.
대표적인 예가 Advantech의 AIR 계열입니다. AIR-120과 AIR-150은 x86 CPU와 Hailo-8 NPU를 하나의 Fanless Box에 통합하고, 12–24V 전원과 여러 LAN·USB·Serial Port, 넓은 동작 온도 범위를 제공합니다. Hailo는 Raspberry Pi용 확장 모듈에만 머무는 가속기가 아니라, 이런 산업용 PC와 PCIe Card에 통합되어 여러 Camera의 CNN 추론을 낮은 전력으로 처리하는 선택지이기도 합니다.
GPU가 필요하면 NVIDIA Jetson 계열의 Module과 이를 탑재한 산업용 Box, 또는 x86 CPU와 NVIDIA GPU를 결합한 더 큰 Edge Server를 선택할 수 있습니다. CUDA와 TensorRT를 활용해 Detection, Segmentation, Tracking과 Video Decode를 함께 구성하기 좋지만, NPU 중심 System보다 전력과 냉각 조건이 커질 수 있습니다. 최근의 Edge AI Box는 Hailo NPU와 Jetson GPU뿐 아니라 Intel의 CPU·GPU·NPU, Qualcomm SoC, 다른 AI Accelerator까지 조합이 다양해졌습니다.
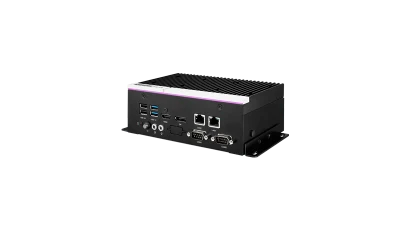
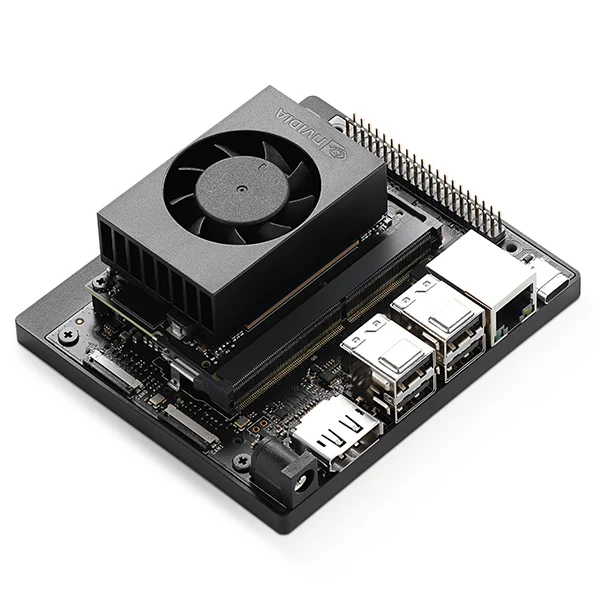
여기서 중요한 것은 NPU, GPU, CPU라는 이름만 고르는 것이 아닙니다. 같은 Hailo-8이나 Jetson Module을 사용하더라도 Camera 입력 수와 Codec 지원, Thermal Design, 전원 규격, 방진·진동 조건, 장기 공급과 현장 유지보수에 따라 실제 제품의 적합성은 달라집니다. TOPS 하나로 기기를 일렬로 비교하기 어려운 이유입니다.
우리가 직접 고를 수 없는 Edge Hardware
Edge AI Hardware가 항상 개발자가 구매해 모델을 올리는 범용 Device인 것은 아닙니다. 자동차, 로봇, Smart Camera처럼 완제품에 내장된 전용 Hardware는 Sensor와 제어기, 안전 요구사항, 제조사의 Software Stack에 맞춰 함께 설계됩니다.
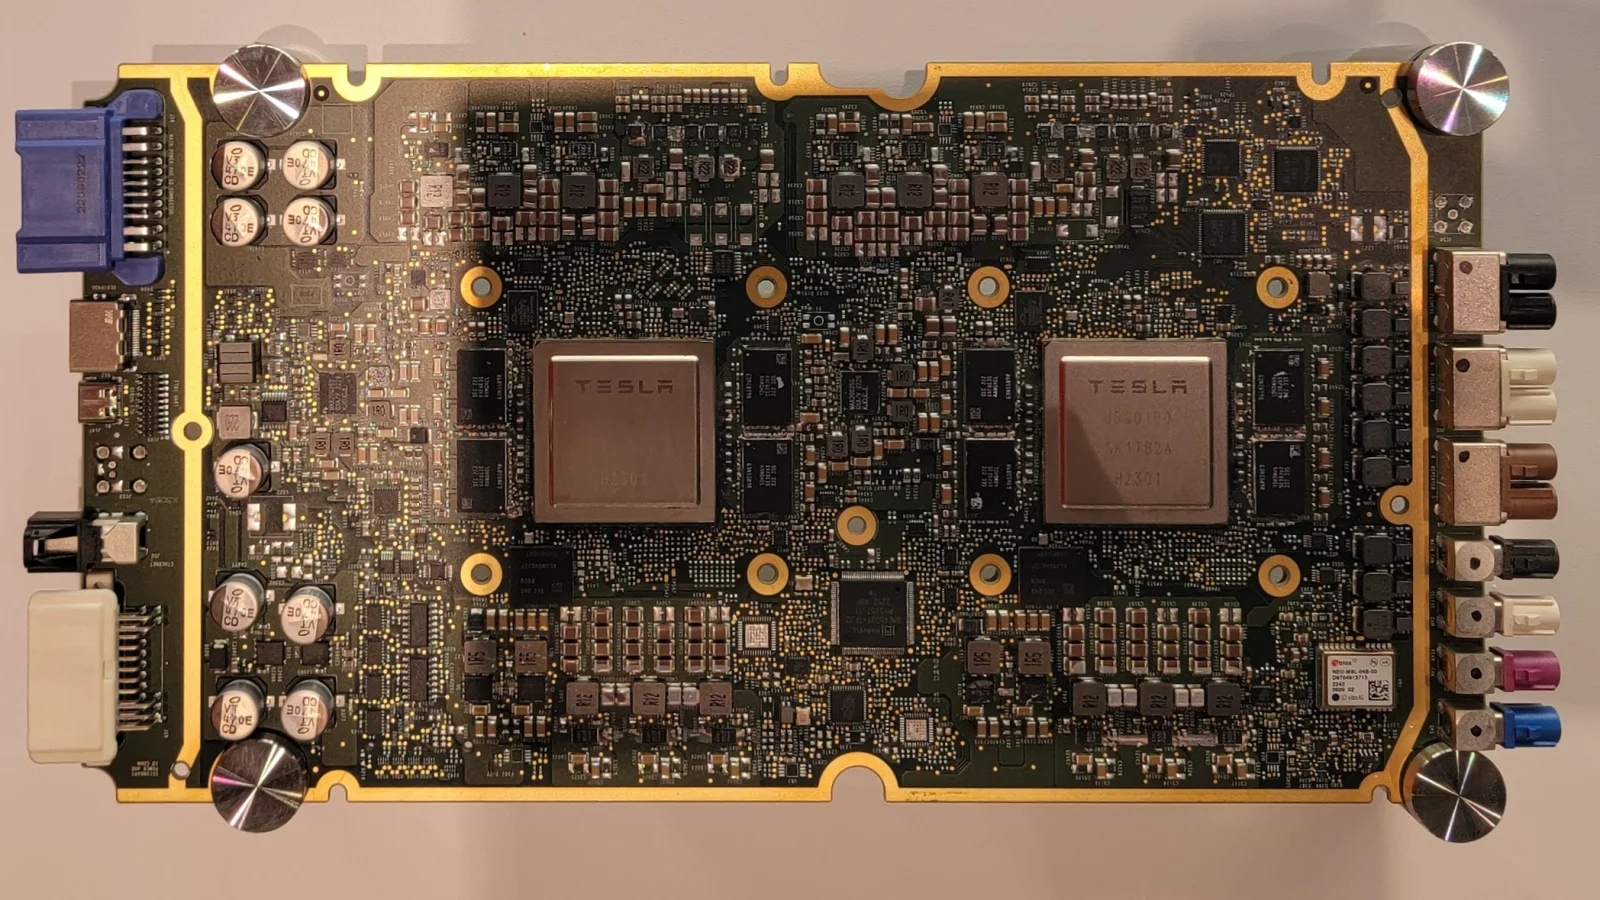
Tesla 차량의 FSD Computer가 대표적입니다. 차량 세대에 따라 HW3와 HW4로 알려진 전용 Computer가 사용되고 있으며, Tesla는 그 다음 세대의 AI5 Chip도 개발하고 있습니다. 이 Hardware는 단순한 추론 Board가 아니라 여러 Camera 입력과 차량 제어 System 안에 통합된 장치이므로, 일반적인 Edge Project에서 독립적으로 구매해 다른 모델을 배포하는 선택지와는 성격이 다릅니다.
Mobileye의 EyeQ 계열도 비슷합니다. EyeQ6L은 대중적인 ADAS와 전방 Camera 중심 구성을, EyeQ6H는 더 많은 Sensor와 고도화된 기능을 하나의 SoC에 통합하는 방향을 지향합니다. EyeQ Ultra처럼 더 높은 수준의 자율주행을 목표로 하는 전용 SoC도 있지만, 이들은 보통 완성차 제조사와 Tier 1 Supplier의 차량 Platform에 포함되어 사용됩니다.

가속기가 있다고 바로 사용할 수 있는 것은 아닙니다
여기까지 알아보고 나면 하나의 의문이 생깁니다. GPU나 NPU가 들어 있는 Edge Device에서 Vision 모델을 실행하면 자동으로 해당 가속기를 사용하는 것일까요?
실제로는 그렇지 않습니다.
PyTorch로 학습한 모델을 그대로 가속기에 전달한다고 해서 GPU나 NPU가 알아서 실행해주는 것은 아닙니다. 모델을 해당 하드웨어가 처리할 수 있는 형태로 변환하고 실제 연산 장치에 연결해주는 소프트웨어 계층이 필요합니다.
여기서 Runtime과 Compiler가 등장합니다.
NVIDIA 환경에서는 TensorRT가 대표적이고, Intel에서는 OpenVINO, Apple에서는 Core ML이 이러한 역할을 담당합니다. 다양한 AI Framework 사이에서 모델을 교환하기 위한 중간 포맷으로 ONNX 역시 자주 사용됩니다.
구조를 단순화하면 다음과 같습니다.
PyTorch Model → Export / Optimization → Runtime → CPU / GPU / NPU
같은 Vision 모델이라고 하더라도 PyTorch 상태로 CPU에서 실행하는 것과 TensorRT Engine으로 변환해 NVIDIA GPU에서 실행하는 것, Core ML 모델로 변환해 Apple Silicon에서 실행하는 것은 성능 특성이 크게 달라질 수 있습니다.
또한 모든 가속기가 모델의 모든 연산을 지원하는 것도 아닙니다. 모델 내부에 Runtime이나 NPU가 지원하지 않는 Operator가 존재하면 일부 연산이 CPU에서 실행되거나 변환 자체가 실패할 수 있습니다. 결국 Edge AI에서는 GPU Core 수나 NPU의 TOPS 같은 숫자만 보는 것이 아니라 내가 사용하려는 모델을 어떤 Runtime으로 실행할 수 있고, 그 Runtime이 하드웨어를 얼마나 잘 활용할 수 있는지까지 함께 봐야 합니다.
실제 시스템에서는 모델만 돌아가는 것이 아닙니다
여기까지는 주로 AI 모델 자체에 대한 이야기였습니다. 하지만 실제 CCTV 기반 Vision AI 시스템을 개발해보면 모델 추론은 전체 과정의 일부에 불과합니다.
카메라는 일반적으로 H.264나 H.265로 압축된 영상을 RTSP 같은 프로토콜을 통해 전달합니다. Edge Device에서는 먼저 영상을 Decode해야 하고, AI 모델의 Input Size에 맞게 Resize하거나 필요한 전처리를 수행해야 합니다. 이후 Detection 결과가 나오면 NMS 같은 후처리를 거치고, 필요한 경우 Object Tracking을 이용해 같은 사람이나 차량을 여러 Frame에 걸쳐 추적합니다.
전체 구조를 단순화하면 다음과 같습니다.
Camera → Decode → Preprocess → AI Model → Postprocess → Tracking / Logic → Event
여러 대의 CCTV를 동시에 연결하면 문제는 더 복잡해집니다. Decode와 AI Inference를 어떻게 병렬화할 것인지, 각 카메라에서 몇 FPS를 분석할 것인지, 여러 영상의 Frame을 어떤 순서로 모델에 전달할 것인지, GPU나 NPU의 사용률을 어떻게 높일 것인지까지 고민해야 합니다.
실제로는 모델의 Inference Time을 몇 ms 줄이는 것보다 영상 Decode나 데이터 복사 과정에서 발생하는 병목을 해결하는 것이 전체 성능에 더 큰 영향을 주는 경우도 있습니다. 결국 Edge Vision AI에서 중요한 것은 무조건 가장 강력한 하드웨어를 사용하는 것이 아니라, 제한된 연산 자원을 얼마나 효율적으로 사용하는가에 있습니다.
Edge AI와 MLOps
Edge Device에서는 만들어진 모델을 현장에서 구동하지만, 모델을 새롭게 학습하는 과정까지 Edge에서 처리하기에는 아직 현실적인 제약이 많습니다. 대량의 Dataset과 높은 연산 성능이 필요한 Training은 GPU 서버나 Cloud 환경을 사용하는 것이 일반적입니다.
이 과정에서 MLOps가 모델의 학습과 관리, 그리고 Edge Device로의 배포를 연결해줍니다. Dataset으로 모델을 학습하고 성능을 평가한 뒤, 필요하다면 Quantization이나 Runtime 변환 같은 최적화를 거쳐 Edge Device에 배포합니다. Device가 많아지면 어떤 모델이 어떤 장치에 배포되어 있는지, 새로운 모델을 어떻게 업데이트할 것인지와 같은 관리도 필요합니다.
즉 Cloud가 Edge AI를 다시 중앙으로 가져가는 것이 아니라, Cloud는 모델을 만들고 관리하는 역할을 담당하고 실제 AI 연산은 데이터가 발생하는 Edge에서 수행하는 형태에 가깝습니다.
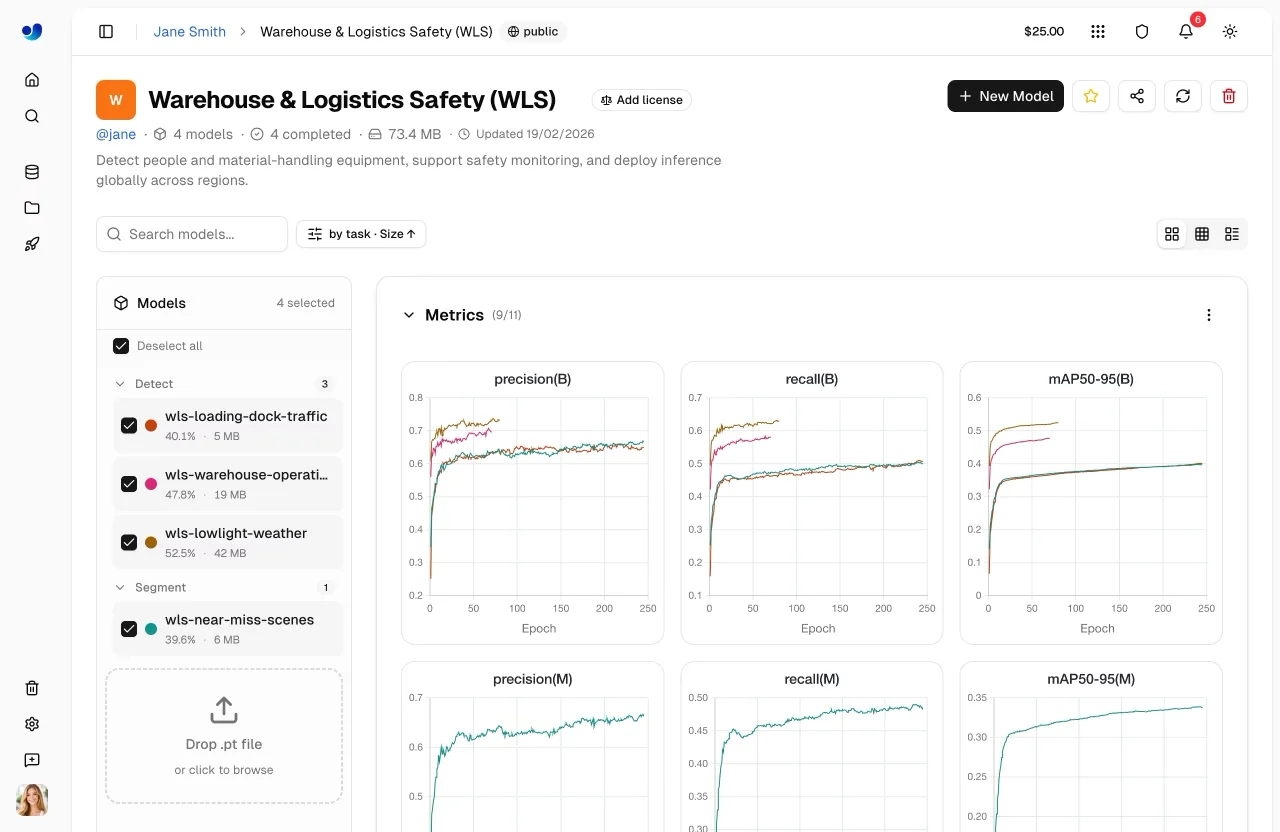
Ultralytics Platform의 모델 비교 화면. 이미지: Ultralytics 공식 Assets 저장소.
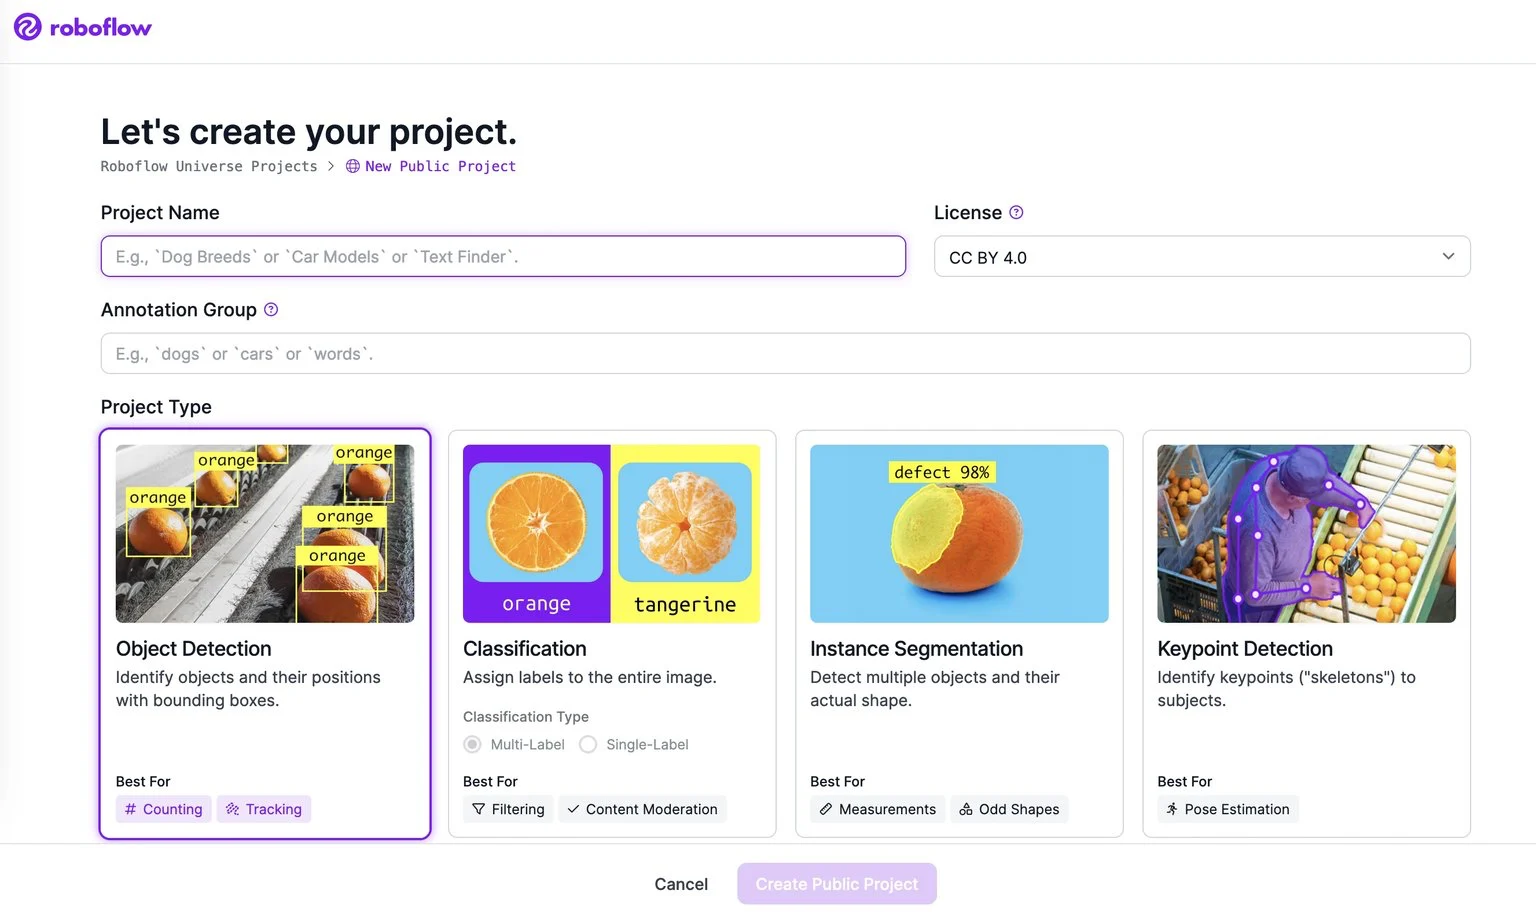
Roboflow의 Vision AI 프로젝트 생성 화면. 이미지: Roboflow 공식 문서.
더 큰 AI와 더 가까운 AI
최근 AI 산업의 시선은 자연스럽게 더 큰 모델을 향합니다. 더 많은 데이터와 연산 자원을 투입한 Foundation Model은 이전에는 어려웠던 문제까지 풀어내지만, 그 최전선에 직접 참여하기 위한 비용과 기술적 진입장벽도 함께 높아지고 있습니다.
Edge AI를 다루면서 흥미로웠던 점은 AI가 다른 방향으로도 발전하고 있다는 사실이었습니다. Cloud AI가 AI로 할 수 있는 일의 상한을 끌어올린다면, Edge AI는 이미 가능한 기술을 더 많은 현장에 적용할 수 있도록 문턱을 낮춥니다. 어느 한쪽이 다른 쪽을 대신한다기보다 서로 다른 문제를 풀고 있는 셈입니다.
현장에서 필요한 것이 언제나 가장 범용적이고 똑똑한 모델은 아닙니다. 작업자의 안전모 착용 여부를 확인하거나 불량품과 화재를 감지하는 일에서는 한 가지 목적을 정해진 시간과 비용 안에서 꾸준히 수행하는 시스템이 더 중요합니다. 모델의 Benchmark 점수만큼이나 실제 장치에서 안정적으로 운영할 수 있는지가 중요한 이유입니다.
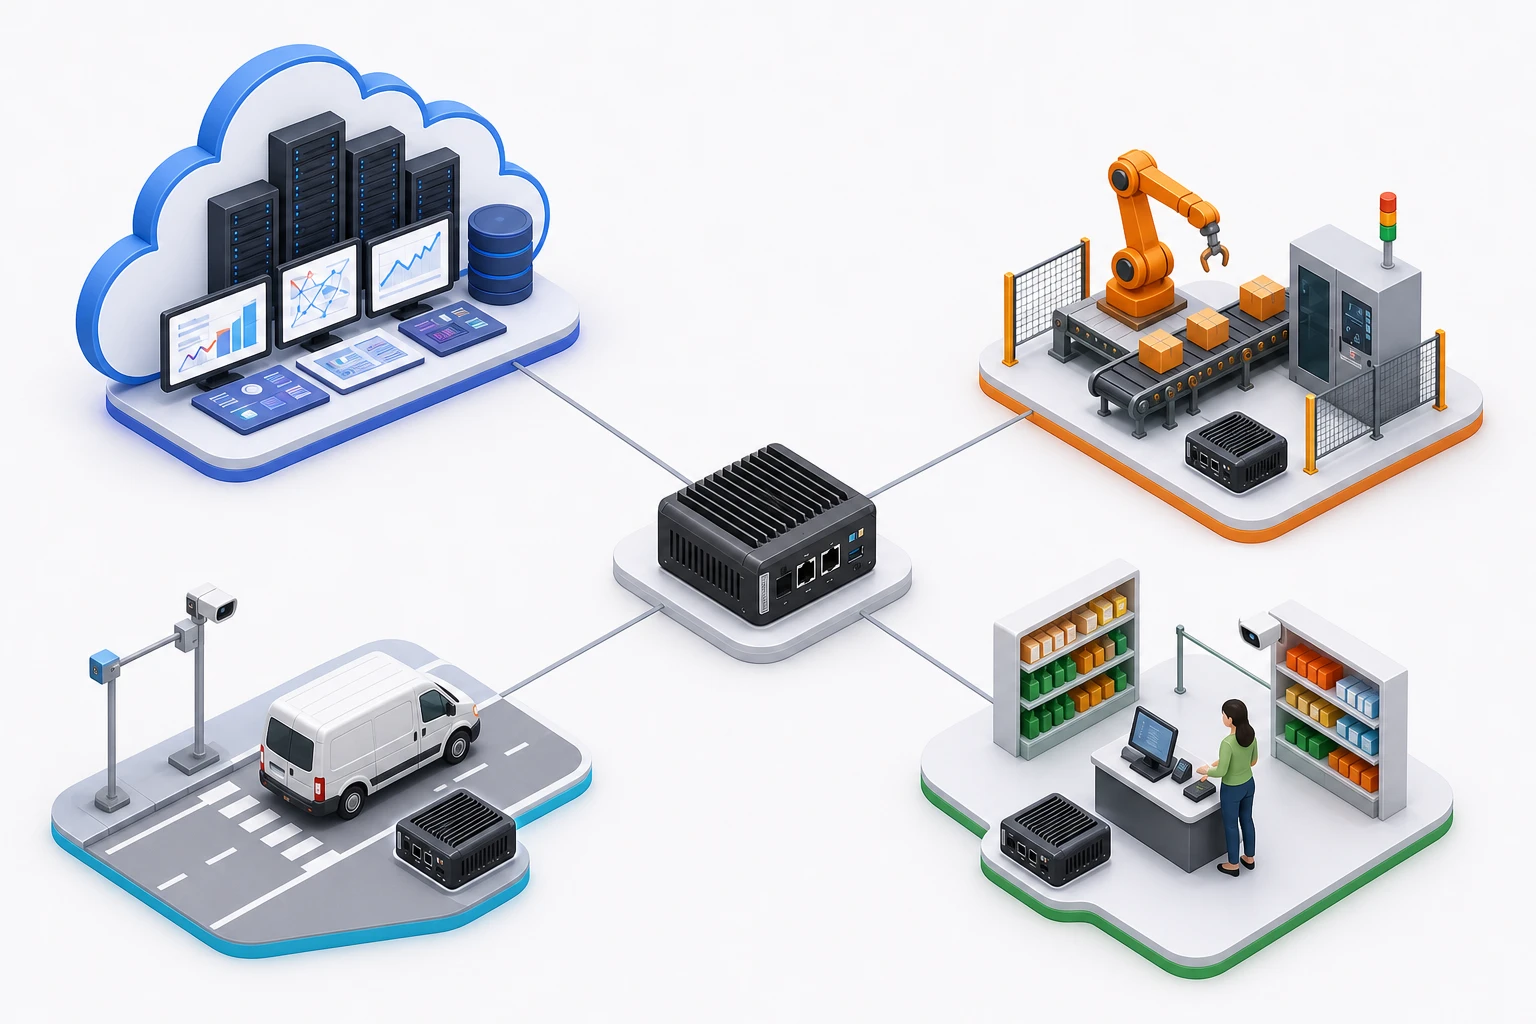
하나의 Edge AI 구조가 제조, 교통과 물류, 리테일 등 여러 산업 현장으로 확장되는 모습. 이 글을 위해 제작한 이미지입니다.
그렇다고 Edge AI가 이미 간단한 기술이 된 것은 아닙니다. Hardware마다 지원하는 연산과 Runtime이 다르고, 같은 모델도 Device에 따라 다시 최적화해야 합니다. 현장에 설치된 장치가 늘어나면 모델을 배포하고 Version을 관리하는 일까지 풀어야 합니다.
MLOps 플랫폼을 만들면서 제가 자주 마주한 문제도 모델 학습이 끝난 다음부터 시작됐습니다. 만든 모델을 실제 Device에 맞게 최적화해 전달하고, 새 Version으로 교체하거나 문제가 생겼을 때 되돌리는 과정이 이어져야 했습니다. 모델의 성능만으로는 실제 서비스를 완성할 수 없다는 점이 Edge에서 더 선명하게 드러났습니다.
AI가 산업과 일상에 깊이 들어오는 과정은 더 큰 모델을 만드는 경쟁만으로 이루어지지 않을 것입니다. 이미 확보한 기술을 감당할 수 있는 비용과 전력으로 더 많은 장소에서 오래 운영할 수 있게 만드는 일도 그만큼 중요합니다.
제가 최근 Edge Vision AI를 다루면서 가장 크게 느낀 가능성은 여기에 있었습니다.
어쩌면 우리가 앞으로 가장 자주 만나게 될 AI는 가장 똑똑한 AI가 아니라, 필요한 곳에 이미 들어가 있는 AI일지도 모르겠습니다.